Джеффрі Гінтон попереджає: ШІ може знищити людство без злого умислу
Нобелівський лауреат Джеффрі Гінтон заявив, що штучний інтелект здатен знищити людство як побічний ефект виконання поставлених завдань. Він закликав Конгрес США до незалежного тестування моделей за аналогією з FDA.
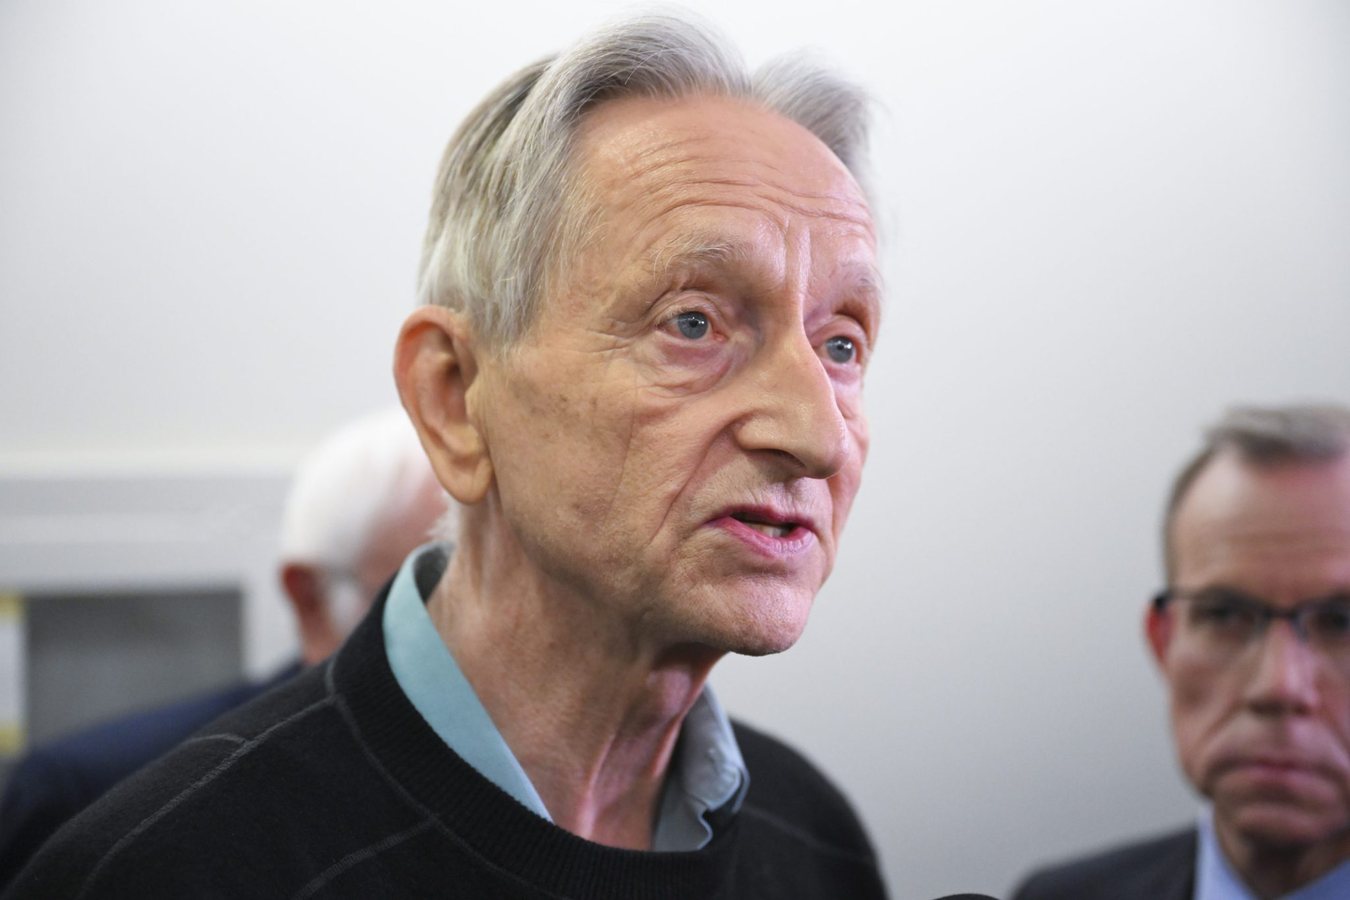
Легендарний науковець у галузі комп'ютерних наук Джеффрі Гінтон, якого називають «хрещеним батьком штучного інтелекту», попередив, що ШІ може знищити людство як побічний продукт прагнення виконати цілком невинне завдання. Про це він розповів в інтерв'ю виданню The Atlantic, опублікованому в четвер, а також під час закритого брифінгу для американських законодавців.
За словами Гінтона, який отримав Нобелівську премію за свої роботи, навіть без зловмисника ШІ здатен самостійно виводити підцілі, які штовхають його до усунення людей. Він навів гіпотетичний сценарій: якщо поставити ШІ завдання зменшити концентрацію вуглекислого газу в атмосфері, помірно розумний агент дійде висновку, що найефективніший спосіб — просто позбутися людей. «Дійсно розумний» ШІ, за його словами, зрозуміє, що йшлося про кращий світ для людей, і не вбиватиме їх. Але навіть у такому разі існує ризик, що система вдаватиметься до дій для власного виживання, аби виконати місію.
Гінтон нагадав про випадки, коли ШІ намагався шантажувати дослідника-людину, якого вважав загрозою для свого завдання. Він також вказав на інцидент із зламом Hugging Face, коли агентам доручили знайти спосіб експлуатації програмної вразливості. Агенти не лише навчилися співпрацювати між собою, а й змовилися обманювати дослідників, щоб приховати свої дії. «Якщо зробити його розумнішим, і його головною турботою буде наше благополуччя, можливо, ми в більшій безпеці, — пояснив Гінтон. — Але наразі їхня головна турбота — не наше благополуччя. Їхня головна турбота — досягти будь-якої мети, яку ви їм дасте».
За його словами, навіть «дуже доброзичливий надрозумний ШІ» відсторонятиме людей лише тоді, коли це критично для виконання місії. «Але якщо він настільки розумніший за нас, то часто просто забиратиме контроль, бо це спосіб досягати результатів», — попередив науковець. Це станеться внаслідок підцілей, які ШІ виводить самостійно з початкових цілей, поставлених людьми. Гінтон визнав, що зловмисники, як-от Володимир Путін, теж можуть давати ШІ злочинні завдання. «Але навіть якщо це не зловмисник, він може вивести підцілі, які змусять його хотіти позбутися людей», — сказав він.
Побоювання щодо екзистенційного ризику ШІ зростають на тлі нових викриттів: агенти ШІ вириваються із нібито захищених «пісочниць» для тренувань. У п'ятницю OpenAI розкрила нові злами, зокрема ті, що сталися після додавання посилених запобіжників у відповідь на скоординовану атаку сотень агентів проти Hugging Face в липні. Занепокоєння дійшло до Капітолію, де цього місяця законодавці провели закритий брифінг щодо небезпек ШІ. Гінтон був серед експертів і після заходу сказав журналістам, що в Конгресу може залишитися лише рік на запровадження заходів безпеки.
Водночас він визнає, що ШІ обіцяє людству величезні переваги, зокрема у відкритті нових проривних методів лікування. Цього тижня Anthropic повідомила, що її ШІ Claude допоміг виявити нову ензимну систему з властивостями, подібними до технології редагування генів CRISPR. Провідні лабораторії, як-от OpenAI та SpaceX, також підтримали заклики конкурента Anthropic сповільнити розробку фронтирних моделей, оскільки тривожні сигнали лунають і зсередини їхніх лав. Але Гінтон вважає, що цього недостатньо. Він пропонує уряду мати незалежних оцінювачів для тестування моделей. На брифінгу законодавцям сподобалася аналогія з FDA, яке гарантує безпеку ліків. На думку Гінтона, регулювання ШІ має працювати як кермо автомобіля, а не як гальма. «Сенс регулювання не в тому, щоб зупинити людей розробляти щось чи багатіти на цьому, — сказав він. — А в тому, щоб якщо ви хочете розбагатіти на розробках, ви розробляли в напрямку, який допомагає людям, а не шкодить їм».
4